模型更新会怎么改变你的 AI 可见度
有一类困惑很常见:这周什么都没改,AI 里提到我们的次数却少了。多数情况下不是被降权,而是模型那边变了 —— 换了检索源、调了回答风格,或者收紧了某类问题的回答策略。理解这一点,才能避免用错误的动作去追一个不存在的问题。
一、三类变化来源
第一类是检索源变化:模型接入的搜索或索引更新,原本能被检索到的页面权重下降,答案里引用的站点换了一批。第二类是回答风格变化:从「列五个选项」变成「给一段解释」,你被提到的位置随之变化,但实际曝光没变。
第三类是策略收紧:涉及医疗、金融、法律等敏感领域时,模型可能改为只给通用建议、不列具体机构。这类变化对全行业同时发生,不是单独针对你。
二、怎么区分「模型变了」和「我变了」
唯一可靠的办法是基线:在动手优化之前,先采一轮完整数据并留档(问题、模型、时间、答案原话)。之后每次复测都与这份基线比,而不是与上周比。
如果同一批问题在多个模型上同时下滑,更可能是检索源或策略层面的变化;如果只有某一个模型变了、且该模型恰好更新过版本,优先怀疑版本差异;如果只有某几个问题变了,才可能与你改动的页面有关。
三、基线要记什么
| 项 | 为什么必须记 |
|---|---|
| 完整提问原文 | 措辞一变,答案就不可比 |
| 模型名称与版本标识 | 区分优化效果与模型升级 |
| 采样时间(含时段) | 与新内容上线时间对齐 |
| 答案原话与引用来源 | 判断「提到」与「引用」的区别,也能发现模型说错的地方 |
四、不该做的事
不该做的第一件是「一波动就改内容」。模型一周内的波动很常见,反复改反而破坏刚建立的结构。第二件是「换个问题再测」,把不同问题的新结果与旧问题的基线放在一起比较。
第三件是「追着单次结果做决策」。单次结果只能说明那一刻,不能说明趋势。第四件是把模型更新当成理由,什么都不做 —— 如果三个模型同时下降且持续两周以上,那更像是真实变化,需要复查内容与引用落点。
五、一个季度可以做的三件事
- 每季度复测一次完整基线,记录模型版本;版本号变了就在报告里注明,不与上一期直接比。
- 把「模型侧变化」写进报告的已知限制,避免客户把波动当成服务质量问题。
- 选三个核心问题做月度观察,只记录位置与引用来源,不做结论。
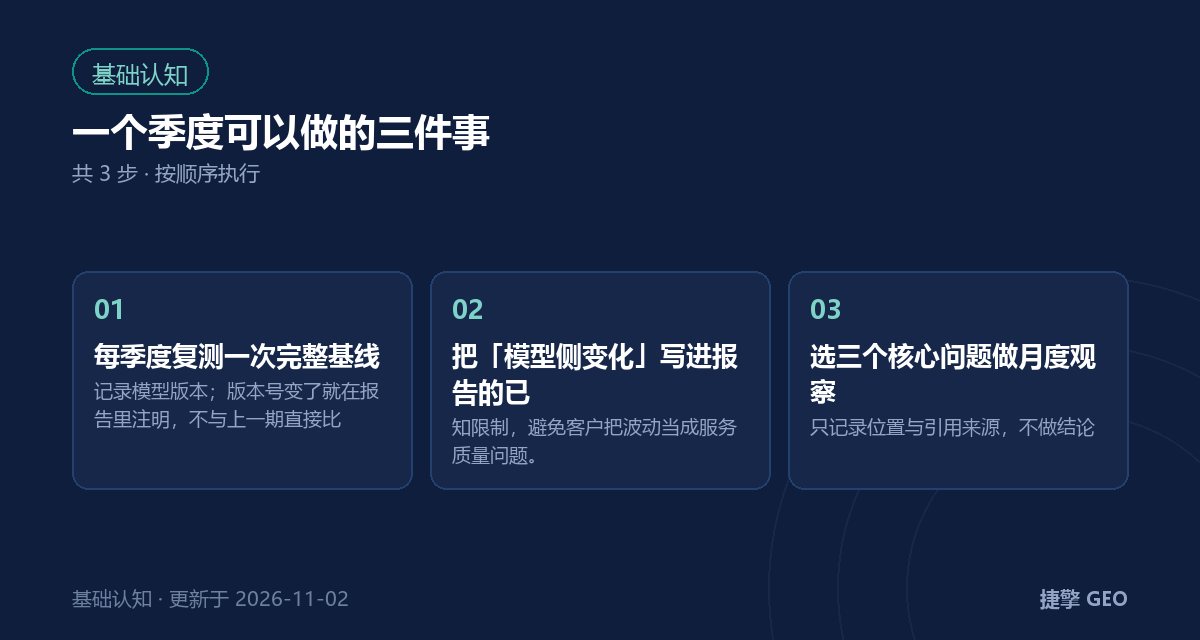
这三件事的共同点是「先记录、后判断」。AI 搜索的观测周期比传统 SEO 更短也更不稳定,把记录做扎实,比任何单次结论都有价值。
六、怎么向客户解释波动
解释波动时,先给结论再给依据:「这一轮数字下降,主要来自模型侧变化,我们的页面与口径没有改动」。紧接着出示三样东西:改动清单(证明没动)、采样口径(证明测法一致)、答案原话(证明变化发生在哪一层)。
避免两种说法:一是「算法调整,没办法」,这等于放弃解释;二是「我们在优化中,下月会好」,这会在下月再次落空。可核的说法是「发现三个模型同时改变了对这类问题的回答方式,我们据此补了两类事实,下轮看能不能重新进入引用」。
七、长期视角
把时间拉长到半年看,模型更新带来的波动会被抹平,留下的是内容质量与来源一致性的差异。所以对模型更新的正确姿态是:知道它存在、记录它的影响、但不围着它转。
真正决定长期结果的,仍是那几件慢事:把事实写清、把口径统一、把可抓取的页面补齐。模型怎么变,这几件事的价值不变。
常见问题
模型更新后旧报告还有效吗?
作为当时的事实有效,但不能与新模型的数据直接比较。报告里应写明采样时的模型与版本。
为什么三个模型结果差这么多?
检索源、训练数据与回答策略不同。差异本身是信息:一个模型提到你、另一个没提到,说明你的内容在某些来源上覆盖不足。
波动多大才算异常?
没有统一阈值。建议以「同一批问题连续两轮同向变化」作为判断起点,单轮不算。