怎么用访问日志判断 AI 爬虫来没来
「AI 爬虫来过了」是这套工作里最容易被随口说出、也最容易被证伪的一句话。日志确实能回答这个问题,但要先排除三件事:UA 可以伪造、CDN 会重复计数、你自己的监控也在抓站。
一、UA 只是线索,不是证据
把 UA 当作证据,是这类统计最常见的起点错误。任何客户端都能把 UA 写成别人的名字;反过来,正经爬虫也会换 UA、换版本号,甚至同一家厂商的抓取、索引与用户代理由不同 UA 承担。只匹配一个名字,要么放进了不该放的,要么漏掉了该算的。
版本串更容易出事。UA 里的版本号随产品迭代变化,写死精确匹配的过滤规则,半年后基本失效;而失效时不会报错,只会让数字悄悄变小,看起来像「爬虫不来了」。可行的用法是把 UA 当筛选条件:先缩小范围,再用 IP 归属与请求行为确认,两步都过才算证据。
二、四步验证法
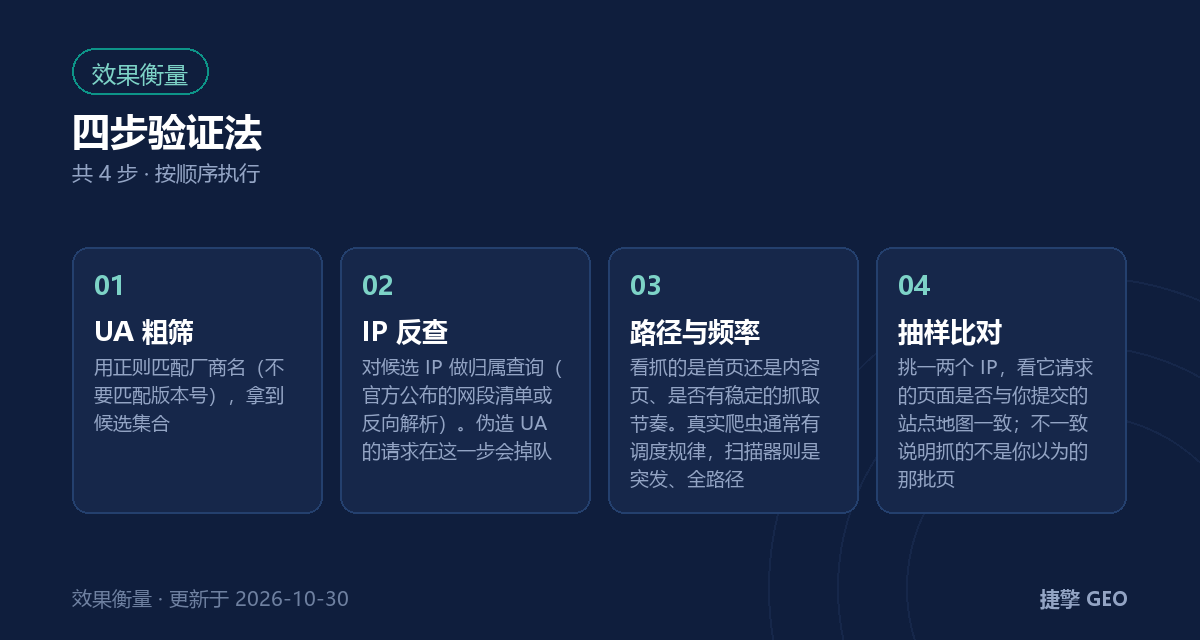
确认一次访问是不是真的,走四步就够,顺序不要换 —— 越往后成本越高,前面能排除的就不必往下走:
- UA 粗筛:用正则匹配厂商名(不要匹配版本号),拿到候选集合。
- IP 反查:对候选 IP 做归属查询(官方公布的网段清单或反向解析)。伪造 UA 的请求在这一步会掉队。
- 路径与频率:看抓的是首页还是内容页、是否有稳定的抓取节奏。真实爬虫通常有调度规律,扫描器则是突发、全路径。
- 抽样比对:挑一两个 IP,看它请求的页面是否与你提交的站点地图一致;不一致说明抓的不是你以为的那批页。
三、日志里该留哪些字段
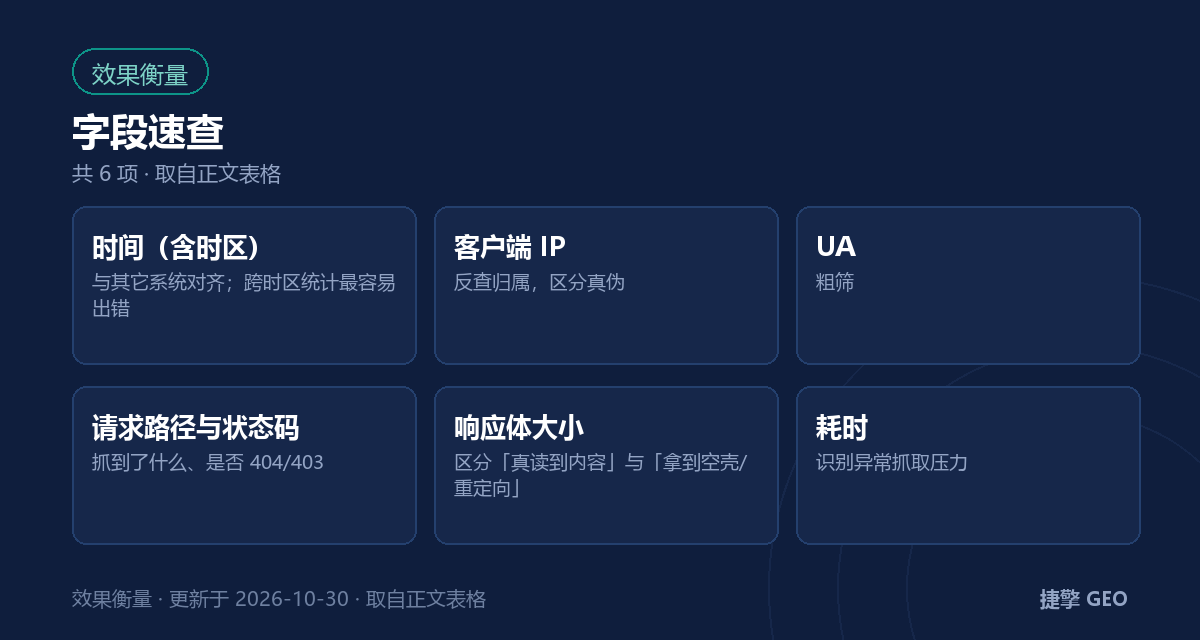
日志字段决定后面能查什么。下面六个是底线,缺任何一个,判断都会退回猜:
| 字段 | 用途 |
|---|---|
| 时间(含时区) | 与其它系统对齐;跨时区统计最容易出错 |
| 客户端 IP | 反查归属,区分真伪 |
| UA | 粗筛 |
| 请求路径与状态码 | 抓到了什么、是否 404/403 |
| 响应体大小 | 区分「真读到内容」与「拿到空壳/重定向」 |
| 耗时 | 识别异常抓取压力 |
表格可左右滑动查看完整内容
保留期建议不少于 90 天。月度对比至少需要三个月的历史,否则「这个月没来」到底是真没来,还是抓取周期本来就长,根本分不清。
四、四个高频误判
误判集中在四个地方。最常见的是 CDN 重复计数:边缘节点和源站各记一次,数字直接翻倍,统计前先确认看的是哪一层日志。第二种是把预取与健康检查当成抓取 —— 部分产品会预取链接或做可用性探测,命中内容页并不代表收录。
第三种是自己人。巡检脚本、拨测服务会定期访问首页,UA 常常写得比真浏览器还像,得按 IP 白名单剔掉。第四种是只看首页:如果对方只抓首页,说明它没进内容层,这时候「有访问」对内容页没有任何意义。这四个错里,前两个把数字放大,后两个让人误判抓取深度,症状不同,后果一样 —— 结论都会偏。
五、月报就三行
月报不需要仪表盘,三行足够支撑决策:本月各引擎的有效命中次数(UA 与 IP 双命中),与上月对比;被抓取页面的前十个,与站点地图核对有没有该抓没抓的页;异常项,包括 404 与 403 的比例、突发扫描、明显伪造的 UA 占比。
这三行要和页面渲染质量、站点地图完整性放在一起看,才能回答「为什么没被引用」。抓不到与不被引用是两件事:前者查日志,后者查内容与竞争。把两件事混在一起,最常见的结果是反复改内容,而问题一直在服务端渲染上。
常见问题
UA 里带厂商名字就一定是真的吗?
不一定,UA 可以任意伪造。必须做 IP 归属校验,并看抓取路径与频率是否符合调度规律。只有 UA 命中的,只能算「疑似」。
没有服务器日志权限怎么办?
退一步用 CDN 或反向代理的访问日志,但要注意回源与边缘两层会重复计数。再退一步,用站点可用性监控记录关键路径的请求来源分布也行,精度会下降。
AI 爬虫抓了就等于会被引用吗?
不等于。抓取只证明内容被读到;能否被引用还取决于重排筛选(相关性、时效、事实密度)与生成阶段的取舍。抓取是必要条件,不是充分条件。
日志要保留多久?
建议不少于 90 天。低于这个长度,月度对比会被抓取周期掩盖,也查不出「某个月突然停了」这种异常。