报告数字对不上:四步复核法
报告数字出现分歧时,最糟的处理是先改结论、再找理由。正确顺序反过来:先把证据冻结,再把分歧拆成四类,能复算的复算,不能复算的写明原因。多数争议到第二步就结束了。
一、先冻结五样东西
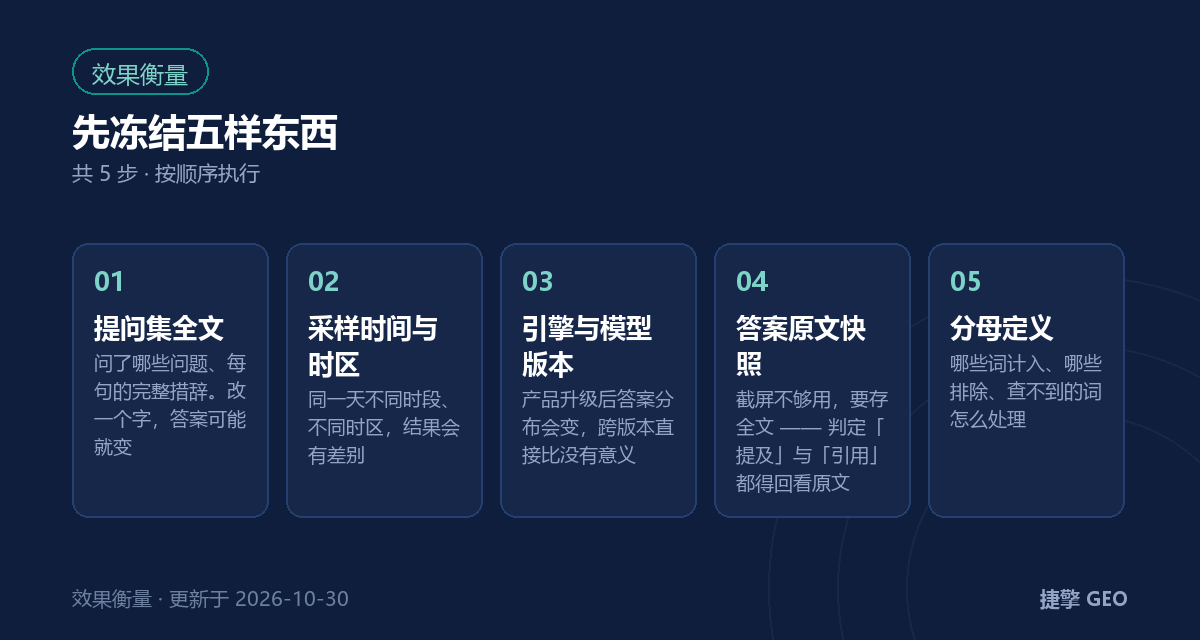
复核的第一步常被理解成「把数重跑一遍」,其实应该先把当时的证据定住。原因很实际:口径之争的最后结局,往往不是分出谁对谁错,而是谁也说不清当时是怎么采的。一旦有人开始重新采样,旧的那批记录就再也对不上,争议会从「数字准不准」变成「谁的记忆更可靠」。所以要冻结五样东西。
- 提问集全文:问了哪些问题、每句的完整措辞。改一个字,答案可能就变。
- 采样时间与时区:同一天不同时段、不同时区,结果会有差别。
- 引擎与模型版本:产品升级后答案分布会变,跨版本直接比没有意义。
- 答案原文快照:截屏不够用,要存全文 —— 判定「提及」与「引用」都得回看原文。
- 分母定义:哪些词计入、哪些排除、查不到的词怎么处理。
五样里最容易被省掉的是原文快照与分母定义。截图看着够用,真到判定时经常要回看上下文;分母不写清楚,后面所有百分比都失去意义。缺了这两样,复核会退化成对口径的二次解释,越解释越乱。
二、四类分歧,四种处置
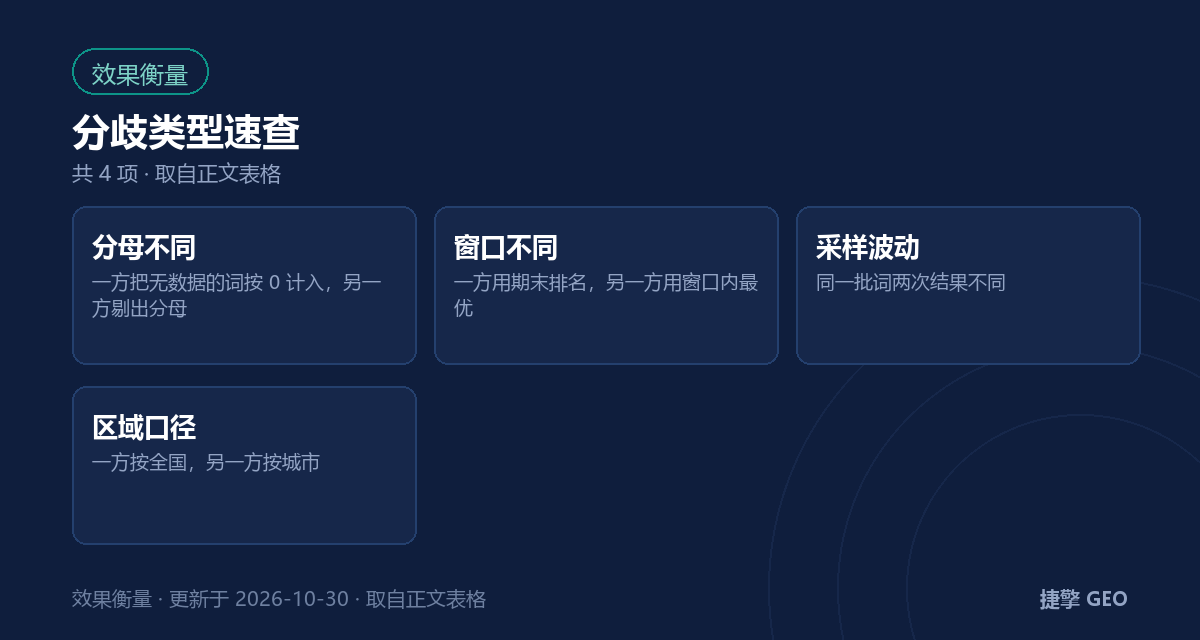
把分歧拆开看,绝大多数落在这四类里:分母不同、窗口不同、采样波动、区域口径。它们的共同点是不涉及数据造假,只是规则没对齐,所以处置方式是回到口径文件、按同一规则重算,而不是重采一遍。
| 分歧类型 | 典型表现 | 怎么处置 |
|---|---|---|
| 分母不同 | 一方把无数据的词按 0 计入,另一方剔出分母 | 回到口径册:无数据显「—」、不计入分母、不补 0;按同一分母重算 |
| 窗口不同 | 一方用期末排名,另一方用窗口内最优 | 统一为「窗口内最优排名」,并写明窗口起止 |
| 采样波动 | 同一批词两次结果不同 | 按抽样误差处理:给样本量与区间,不把单次差异当结论 |
| 区域口径 | 一方按全国,另一方按城市 | 区域榜与全国榜分列,不混算成一个达标率 |
表格可左右滑动查看完整内容
顺序很关键。先把这四类排掉,再怀疑工具或数据源;反过来做,会花大量时间验证采样脚本,而答案往往写在那份没人细看的口径文件里。最常见的一种是:两边各拿一份报告,数字差一倍,追下去发现一边把没查到的词按 0 计入,另一边剔出了分母 —— 都不算错,只是分母不同。
三、一页复算模板
复算不需要重跑采样,一张能逐行对上的表就够:词与问题、引擎、采样时间、是否提及与是否引用、位置、是否在分母内。
| 列 | 填什么 |
|---|---|
| 词 / 问题 | 与提问集逐字一致 |
| 引擎 | 具体产品,不用「AI 搜索」这种统称 |
| 采样时间 | 精确到分钟 + 时区 |
| 是否提及 / 是否引用 | 按原文判定,勾选并附原文片段 |
| 排名或引用位置 | 有则填,无则显「—」 |
| 是否在分母内 | 不在分母的,整行不参与汇总 |
表格可左右滑动查看完整内容
填完表,争议通常只剩两种:同一段原文怎么判、这一行算不算分母。两者都能当场解决,不需要再来一轮采样。这张表还有第二个用处 —— 留证。换人接手、对方换了对接人,把表拿出来就能继续谈,不必从头解释规则。
四、什么时候该重采,什么时候不该
该重采的情况其实只有三种:引擎明确升级了模型或检索方式;站点做了结构性改动,比如换域名、改模板、大批页面下线;提问集本身被修改。这三件事都会让新旧结果不具可比性,此时应该重设基线,而不是在旧基线上修补。
更多的情况是不该重采:单次结果与上期不同,但样本量与区间能覆盖这个差异;换了设备、换了人操作;同一批词在短时间内反复采。最后一种最费时间也最没用 —— 重复采样不会让结果更准,只会让记录更难对账。真要做的是把样本量加上去、让区间收窄,而不是多跑几遍取一个「看起来更稳」的数字。
五、把复核写进合同,比事后解释便宜
与其事后解释,不如签约前写清四件事:采样方式,包括提问集、引擎清单、频次与样本量;判定规则,即什么算提及、什么算引用、无数据怎么处理;复算权限,客户能否拿到原始记录与原文快照;变更流程,改提问集或换引擎时怎么通知、是否重设基线。这四句在合同里只占半页,能省掉后面几个月的反复。
常见问题
两份报告差很多,是不是有一方在造假?
先别下这个结论。多数差异来自分母、窗口、采样与区域口径不同,属于规则问题而非诚信问题。按四类逐一核对,通常能定位到具体一行。
客户自己截图问 AI,结果和报告不一样,怎么解释?
先确认三件事:问题措辞是否完全一致、是否同一产品同一版本、是否同一时段。三样有一项不同,结果不同就是正常的,不需要解释成「报告错了」。
复算要不要把全部词重跑一遍?
不需要。复算的目的是对齐口径,不是重做采样。按同一规则重算已有记录即可;只有在引擎升级或站点大改时才需要重设基线。
报告里没有数据的词怎么处理?
显「—」,不计入分母,不补 0。把它当 0 会系统性拉低达标率,也会掩盖「这个词根本没被采样到」这个更重要的问题。